
Inhalt
PERSÖNLICHE EINORDNUNG
Je intensiver ich KI in meiner täglichen Arbeit eingesetzt habe, desto weniger ging es für mich um die Frage, ob sie Texte formulieren kann. Interessant wurde sie dort, wo sie fachliche Arbeit beschleunigt: Informationen strukturieren, Unterlagen vergleichen, technische Fragen vorbereiten, Software und Automatisierungen entwickeln oder vorhandenes Wissen besser nutzbar machen.
Gleichzeitig wurde mir immer deutlicher, dass die Geschwindigkeit und Überzeugungskraft einer KI auch eine Schwäche sein kann. Eine Antwort kann sehr plausibel klingen und trotzdem falsch, unvollständig oder für die konkrete Aufgabe ungeeignet sein. Hinzu kommt die Frage, welche Informationen ich einem externen System überhaupt geben möchte.
Aus diesen Überlegungen entstand mein Projekt „KI unter eigener Kontrolle“. Dabei geht es mir nicht darum, Cloud-KI grundsätzlich durch lokale KI zu ersetzen. Ich möchte vielmehr bewusst entscheiden können, welches Werkzeug welche Daten erhält, wie Ergebnisse geprüft werden und wo das dauerhafte Wissen meines Unternehmens verbleibt.
Warum überhaupt KI?
Bevor man über lokale Sprachmodelle, RAG, Agenten oder eigene Wissenssysteme spricht, sollte man eine einfachere Frage beantworten: Warum sollte ein technisches Unternehmen überhaupt KI einsetzen?
Für mich liegt der Nutzen vor allem darin, bestimmte Arbeiten schneller und systematischer vorzubereiten. KI kann große Informationsmengen strukturieren, Dokumente gegenüberstellen, Fragestellungen zerlegen, Varianten entwickeln und bei wiederkehrenden digitalen Aufgaben unterstützen. Sie kann Recherche, Dokumentation, Programmierung und Analyse beschleunigen.
Das macht sie aber nicht zum Ersatz für den Fachmann. Der entscheidende Punkt ist, KI als Werkzeug zu verstehen. Ein gutes Werkzeug kann die Leistungsfähigkeit eines erfahrenen Anwenders erheblich erhöhen. Es übernimmt damit jedoch weder automatisch die fachliche Verantwortung noch die Freigabe eines Ergebnisses.
Die eigentliche Stärke liegt jenseits von E-Mails und Texten
Viele Menschen lernen generative KI zunächst über einfache Aufgaben kennen: eine E-Mail formulieren, einen Text zusammenfassen oder Ideen sammeln. Das ist nützlich, zeigt aber nur einen kleinen Teil des möglichen Nutzens.
Was mir bei vielen KI-Videos gefehlt hat
Ein weiterer ausschlaggebender Grund für diese Blogreihe entstand beim Ansehen vieler YouTube-Videos über künstliche Intelligenz. Ich fand dort viel Wissen über Modelle, technische Begriffe, neue Funktionen und die rasante Entwicklung der Systeme. Was mir dabei jedoch häufig fehlte, war die Brücke in die betriebliche Realität: Was mache ich damit morgen in einem technischen Unternehmen? Wie sieht eine konkrete Anwendung aus? Wo entsteht tatsächlich ein Nutzen – und wo beginnen die Grenzen?
Genau diese Lücke möchte ich mit dieser Reihe aus meiner Perspektive schließen. Ich will KI nicht nur abstrakt oder hochwissenschaftlich beschreiben, sondern an realen Fragestellungen zeigen, welche Möglichkeiten sich ergeben, welche Entscheidungen notwendig werden und welche Probleme auf dem Weg tatsächlich auftreten. Dazu gehören auch Versuche, die nicht sofort funktionieren, und Fragen, auf die es keine einfache Standardantwort gibt.
Die Serie soll deshalb Theorie und Praxis miteinander verbinden. Nicht mit dem Anspruch, für jedes Unternehmen die eine richtige Lösung vorzugeben, sondern so konkret, dass Geschäftsführer, Fachanwender und technische Entscheider erkennen können, was KI im Arbeitsalltag leisten kann – und was dafür organisatorisch, fachlich und technisch geklärt werden muss.
Für ein technisches Unternehmen wird KI dort besonders interessant, wo Informationen, Fachwissen und digitale Werkzeuge zusammenkommen. Sie kann bei der Vorbereitung technischer Entscheidungen, bei Dokumentenanalysen, bei Software- und Excel-Aufgaben, beim Aufbau strukturierter Wissensbestände oder bei der Beobachtung relevanter Informationsquellen unterstützen.
Die ausführlichen wirtschaftlichen Anwendungsfälle gehören bewusst in einen späteren Beitrag dieser Serie. Für den Einstieg ist zunächst entscheidend: Je tiefer KI in reale Unternehmensprozesse eingebunden wird, desto wichtiger werden Fachkompetenz, Datenkontrolle und eine klare Prüflogik.
Die Vorteile sind groß – die Fehlanwendung kann es ebenfalls sein
Eine der beeindruckendsten Eigenschaften moderner KI ist ihre Geschwindigkeit. Genau daraus kann jedoch ein Risiko entstehen. Eine Antwort erscheint in Sekunden, ist häufig sauber gegliedert und sprachlich überzeugend. Diese Form darf nicht mit fachlicher Richtigkeit verwechselt werden.
Eine KI kann Randbedingungen übersehen, eine Aufgabenstellung anders interpretieren als beabsichtigt oder auf einer falschen Annahme aufbauen. Besonders kritisch wird es, wenn der Anwender das Ergebnis nicht selbst beurteilen kann.
Bei technischen Aufgaben bedeutet das beispielsweise: Berechnungen müssen nachvollzogen, technische Aussagen plausibilisiert, Norm- oder Rechtsbezüge geprüft und erzeugter Programmcode getestet werden. Je größer die mögliche Auswirkung eines Fehlers ist, desto wichtiger wird die menschliche Prüfung.
Für mich ergibt sich daraus ein einfacher Grundsatz: Plausibel ist nicht automatisch richtig.
KI ist nur so gut wie die fachliche Führung durch den Anwender
Der zentrale Leitsatz dieser Serie lautet: KI ist nur so gut wie die fachliche Führung durch den Anwender.
Dazu gehört bereits die Aufgabenstellung. Wer die fachlichen Randbedingungen nicht kennt, kann sie einer KI häufig auch nicht vollständig mitteilen. Dann kann ein sprachlich hervorragendes Ergebnis entstehen, das am eigentlichen Problem vorbeigeht.
Prompt-Kompetenz ist deshalb hilfreich, ersetzt aber keine Fachkompetenz. Ich muss wissen, welche Informationen für eine Aufgabe relevant sind, welche Annahmen zulässig sind und woran ich erkenne, ob ein Ergebnis belastbar ist.
Richtig eingesetzt kann KI Fachwissen dagegen verstärken. Sie kann Vorarbeiten übernehmen, Alternativen sichtbar machen, Informationen strukturieren und Prüf- oder Review-Fragen vorbereiten. Die fachliche Entscheidung, Bewertung und Freigabe bleiben beim Menschen.
Dann kommt die Datenfrage
Sobald KI nicht mehr nur allgemeine Fragen beantwortet, sondern mit realen Unternehmensaufgaben arbeitet, benötigt sie Kontext. Das können technische Dokumente, Projektunterlagen, Kalkulationen, interne Notizen, Kundendokumente oder vorhandene Wissensbestände sein.
Damit verändert sich die Fragestellung grundlegend. Es geht nicht mehr nur darum, ob eine KI eine Aufgabe lösen kann. Ich muss zusätzlich entscheiden, welche Informationen das jeweilige System überhaupt erhalten soll.
Öffentlich verfügbare Informationen, interne Unterlagen, private Daten und Kundendaten sind nicht dasselbe. Auch Zugangsdaten, vertrauliche Projektinformationen oder Geschäftsgeheimnisse benötigen eine andere Behandlung als öffentliches Fachwissen.
Genau an diesem Punkt wurde aus meiner allgemeinen Beschäftigung mit KI die Frage nach Datenkontrolle.
Nicht lokal gegen Cloud – sondern bewusst über den Datenweg entscheiden
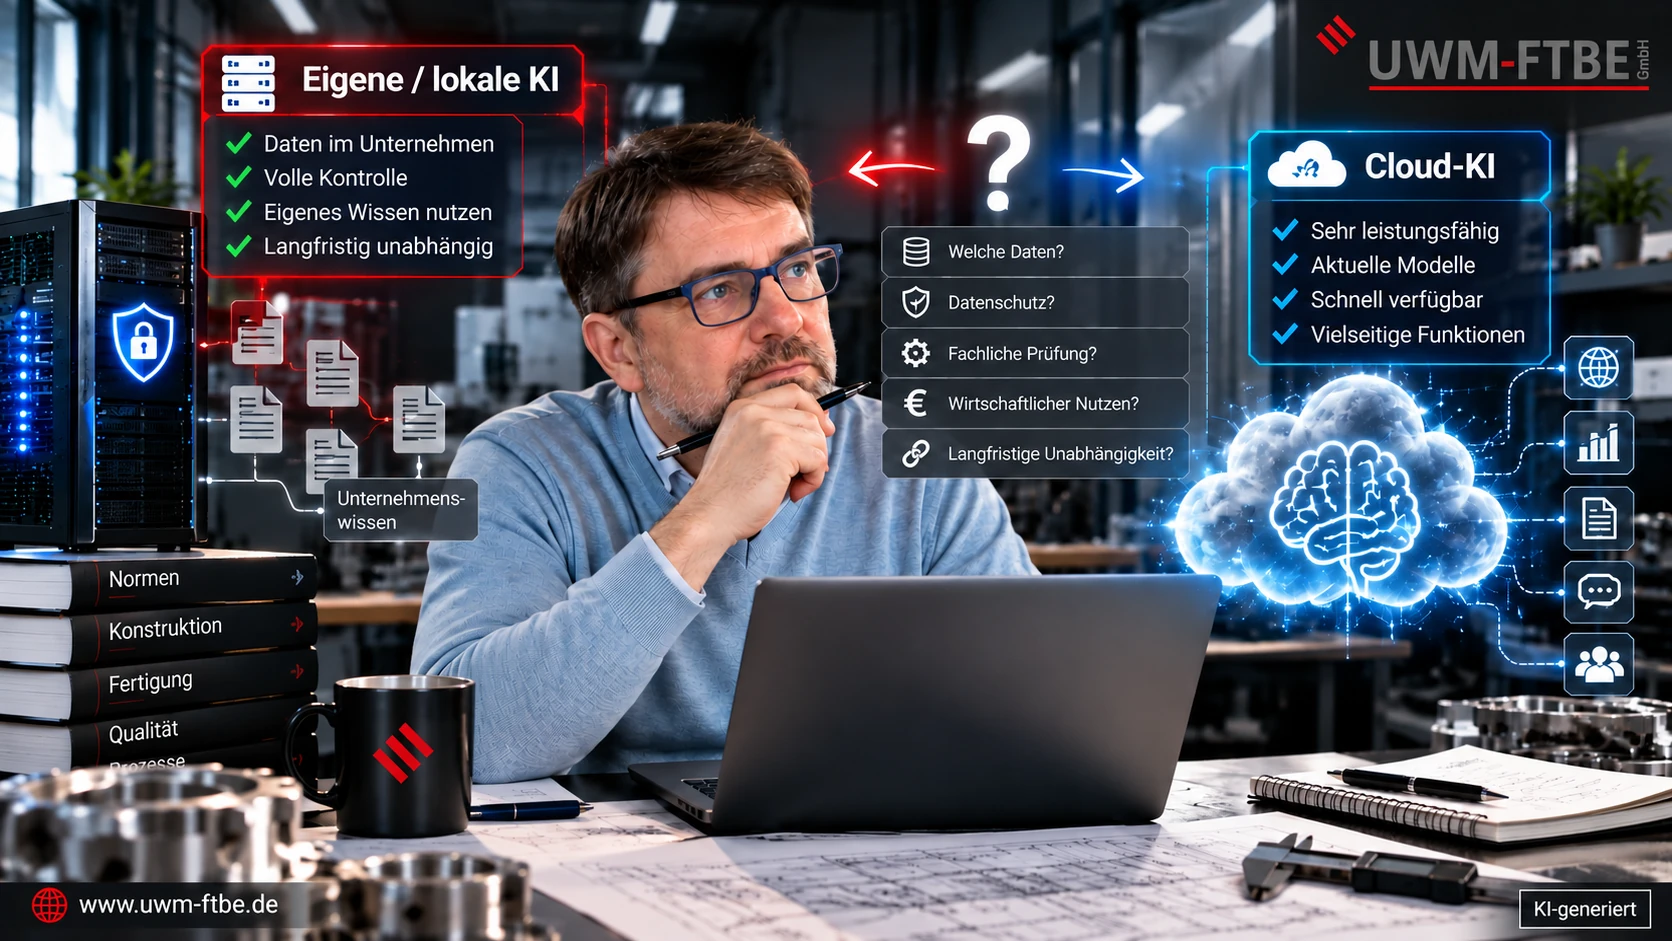
Ich halte wenig davon, aus „lokal“ und „Cloud“ einen Glaubenskrieg zu machen. Beide Ansätze können je nach Aufgabe Vorteile und Grenzen haben.
Cloud-KI kann sehr leistungsfähig sein und Funktionen bereitstellen, die lokal nicht ohne Weiteres verfügbar sind. Eine lokale Umgebung kann dagegen interessant sein, wenn bestimmte Informationen bewusst innerhalb der eigenen technischen Umgebung verarbeitet werden sollen oder wenn das eigene Wissenssystem unabhängig von einem einzelnen Anbieter aufgebaut werden soll.
Der entscheidende Punkt ist für mich daher nicht, alles zwanghaft lokal zu betreiben. Ich möchte selbst entscheiden können, welche Daten lokal bleiben, welche Informationen ein Cloud-Dienst erhält und wann eine Kombination beider Welten sinnvoll ist.
Diese bewusste Entscheidung über den Datenweg wird zu einem der roten Fäden dieser Serie.
„Eigene KI“ bedeutet nicht, ein eigenes Grundmodell zu entwickeln
Der Begriff „eigene KI“ kann leicht missverstanden werden. Gemeint ist in diesem Projekt nicht, ein großes Sprachmodell von Grund auf selbst zu trainieren.
Mich interessiert vielmehr die kontrollierbare Umgebung um die Modelle herum: eigene Datenbestände, nachvollziehbare Verarbeitung, klare Freigaben und die Möglichkeit, Modelle oder Anbieter auszutauschen.
Heute kann ein bestimmtes Modell für eine Aufgabe geeignet sein, morgen ein anderes. Deshalb sollte dauerhaftes Unternehmenswissen nicht so organisiert werden, dass es nur mit einem einzelnen Anbieter funktioniert.
Für mich sind die Modelle Werkzeuge. Das wertvollere und langfristigere Gut sind die eigenen Informationen, Erfahrungen, Entscheidungen und freigegebenen Wissensbestände.
Aus Dateien wird nicht automatisch Unternehmenswissen
Im Verlauf der Überlegungen wurde schnell deutlich, dass eine lokale KI allein das eigentliche Problem nicht löst. Ein Ordner mit Tausenden Dateien ist noch kein verlässliches Wissenssystem.
Dokumente können veraltet, doppelt, unvollständig oder widersprüchlich sein. Scans können schlecht lesbar sein. Mehrere Revisionen können nebeneinander liegen. Und nicht jede Information, die irgendwo gespeichert wurde, ist automatisch fachlich geprüft und freigegeben.
Daraus entstand für das Projekt ein weiteres Grundprinzip: RAW → PROCESSED → APPROVED.
Rohmaterial wird zunächst verarbeitet und eingeordnet. Erst geprüfte Inhalte sollen als freigegebene Wissensgrundlage dienen. Die Herkunft muss dabei nachvollziehbar bleiben. Damit verschiebt sich der Schwerpunkt von „Welches KI-Modell installiere ich?“ zu einer wesentlich wichtigeren Frage: Wie baue ich ein belastbares, kontrollierbares Unternehmenswissen auf, das verschiedene KI-Werkzeuge nutzen können?
Ich wusste am Anfang noch nicht, wohin das Projekt führen würde
Diese Serie soll keine rückwirkend glattgezogene Erfolgsgeschichte werden. Zu Beginn standen deutlich mehr Fragen als Antworten.
Wie leistungsfähig ist lokale KI auf realistischer Hardware? Welche Modelle sind für welche Aufgaben geeignet? Wie bindet man eigenes Wissen ein? Wie verhindert man, dass ungeprüfte oder veraltete Informationen als vermeintliche Wahrheit zurückkommen? Wie behandelt man Dubletten, Scans und Revisionen? Und wie müssen Backup und Wiederherstellung aussehen, bevor wirklich wichtige Daten in ein solches System einfließen?
Ein Teil dieser Fragen führte zu Lösungen. Andere führten zu neuen Problemen, die am Anfang noch gar nicht sichtbar waren.
Genau diesen Weg möchte ich in der Serie dokumentieren: nicht als Anleitung zum blinden Nachbauen, sondern als nachvollziehbare Entwicklung mit Entscheidungen, Fehlannahmen, Tests und Erkenntnissen.
Offen erklären – ohne Kunden- und Unternehmenswissen preiszugeben
Eine Fachserie muss echten Nutzen liefern. Der Leser soll nach einem Beitrag sein Problem besser verstehen und sinnvolle nächste Fragen stellen können.
Das bedeutet für mich, grundlegende Zusammenhänge, Entscheidungslogiken, typische Fehlerklassen und Lessons Learned offen zu erklären. Gleichzeitig gibt es klare Grenzen. Kundendaten, Zugangsdaten, produktive Sicherheitskonfigurationen, vollständige interne Masterprompts und geschäftskritische Detailmethoden gehören nicht in einen öffentlichen Blog.
Das ist keine künstliche Verknappung von Wissen. Es ist die notwendige Trennung zwischen fachlichem Mehrwert für den Leser und dem Schutz von Kunden, Systemen und eigenem Unternehmens-Know-how.
Fazit: Die Frage nach der eigenen KI begann nicht mit der Technik
Rückblickend begann dieses Projekt für mich nicht mit der Frage, welches Sprachmodell ich installieren sollte. Am Anfang standen drei andere Fragen: Was kann KI für meine Arbeit tatsächlich leisten? Wie verhindere ich, dass ein leistungsfähiges Werkzeug durch falsche Anwendung zum Risiko wird? Und wie behalte ich die Kontrolle über die Informationen, mit denen ich arbeite?
Aus diesen Fragen entstand die Idee einer eigenen KI-Umgebung. Nicht als abgeschottete Insel und nicht als pauschaler Ersatz für Cloud-KI, sondern als Teil einer kontrollierten Werkzeuglandschaft.
Im nächsten Beitrag wird die Datenfrage deshalb konkreter: Welche Daten würde ich einer Cloud-KI geben – und welche niemals?
Hinweis zu rechtlichen und regulatorischen Informationen – Stand September 2026
Dieser Beitrag wurde mit fachlicher Sorgfalt und auf Grundlage der zum Zeitpunkt der Veröffentlichung verfügbaren Informationen erstellt. Trotz sorgfältiger Recherche können Fehler, Unvollständigkeiten oder zwischenzeitliche Änderungen der Rechts- und Informationslage nicht vollständig ausgeschlossen werden.
Rechtliche und regulatorische Anforderungen an den Einsatz künstlicher Intelligenz entwickeln sich weiter. Die entsprechenden Informationen in diesem Fachbeitrag geben daher den zum Veröffentlichungszeitpunkt recherchierten Stand wieder und stellen keine Rechtsberatung dar.
Für konkrete betriebliche Anwendungen sind die jeweils aktuellen gesetzlichen Vorgaben, behördlichen Veröffentlichungen, vertraglichen Verpflichtungen sowie die Bedingungen der eingesetzten Systeme und Dienste zu prüfen.
Quellen / fachliche Grundlage
Der Beitrag basiert auf der UWM-FTBE-Projektarbeit zur kontrollierten Nutzung künstlicher Intelligenz und auf eigener technischer Bewertung. Rechtliche und regulatorische Aussagen wurden für diese technische Überarbeitung anhand offizieller europäischer Primärquellen auf Aktualität geprüft.
- EUR-Lex: Datenschutz-Grundverordnung (EU) 2016/679, insbesondere die Grundsätze der Verarbeitung personenbezogener Daten.
- Europäischer Datenschutzausschuss (EDSA): Stellungnahme 28/2024 zu Datenschutzaspekten bei KI-Modellen.
- EUR-Lex: Verordnung (EU) 2024/1689 über künstliche Intelligenz einschließlich der bis September 2026 geltenden Änderungen und gestaffelten Anwendungsregelungen.
- UWM-FTBE GmbH: eigene Projektarbeit und fachliche Einordnung zur lokalen und hybriden Unternehmens-KI.
Wie UWM-FTBE bei der Einführung von KI unterstützen kann
Wer KI im Unternehmen produktiv einsetzen möchte, braucht mehr als die Auswahl eines Modells. Datenklassen, Prozesse, Verantwortlichkeiten, vorhandene Systeme, Fachwissen und die gewünschte Arbeitsteilung zwischen lokalen und externen Diensten müssen zusammenpassen.
UWM-FTBE unterstützt technische Unternehmen dabei, solche Einsatzmöglichkeiten strukturiert aufzunehmen, fachlich zu bewerten und einen nachvollziehbaren Einführungsweg zu entwickeln. Im Mittelpunkt steht nicht möglichst viel KI, sondern ein sinnvoller, kontrollierbarer Einsatz im jeweiligen Unternehmen.
Vorheriger Fachbeitrag:
Artikel 003
Nächster Beitrag:
Artikel 005 – Welche Daten würde ich einer Cloud-KI geben – und welche niemals?