
Inhalt
PERSÖNLICHE EINORDNUNG
Als ich begonnen habe, mich mit einer eigenen KI-Umgebung für UWM-FTBE zu beschäftigen, war eine Frage schnell entscheidend: Muss ich dafür tatsächlich eine eigene KI entwickeln? Der Begriff „eigene KI“ klingt zunächst so, als müsste ein Unternehmen ein Sprachmodell selbst bauen und trainieren. Genau das ist in meinem Projekt aber nicht das Ziel.
Mir geht es um etwas anderes: Ich möchte die Kontrolle über meine Daten, mein dauerhaftes Unternehmenswissen, die Freigaben und die technische Architektur behalten. Das Sprachmodell soll dabei ein Werkzeug sein – nicht der Ort, an den das Unternehmen sein gesamtes Wissen dauerhaft bindet.
Diese Trennung verändert die Aufgabenstellung erheblich. Statt ein riesiges Grundmodell selbst zu entwickeln, kann ich vorhandene Modelle nutzen und prüfen, welches davon für eine bestimmte Aufgabe geeignet ist. Wenn sich Anforderungen oder Technik ändern, soll ein Modell austauschbar bleiben. Die eigentliche Investition steckt damit nicht nur im Modell, sondern vor allem in einer belastbaren Wissens- und Systemarchitektur.
„Eigene KI“ und „eigenes Sprachmodell“ sind zwei verschiedene Dinge
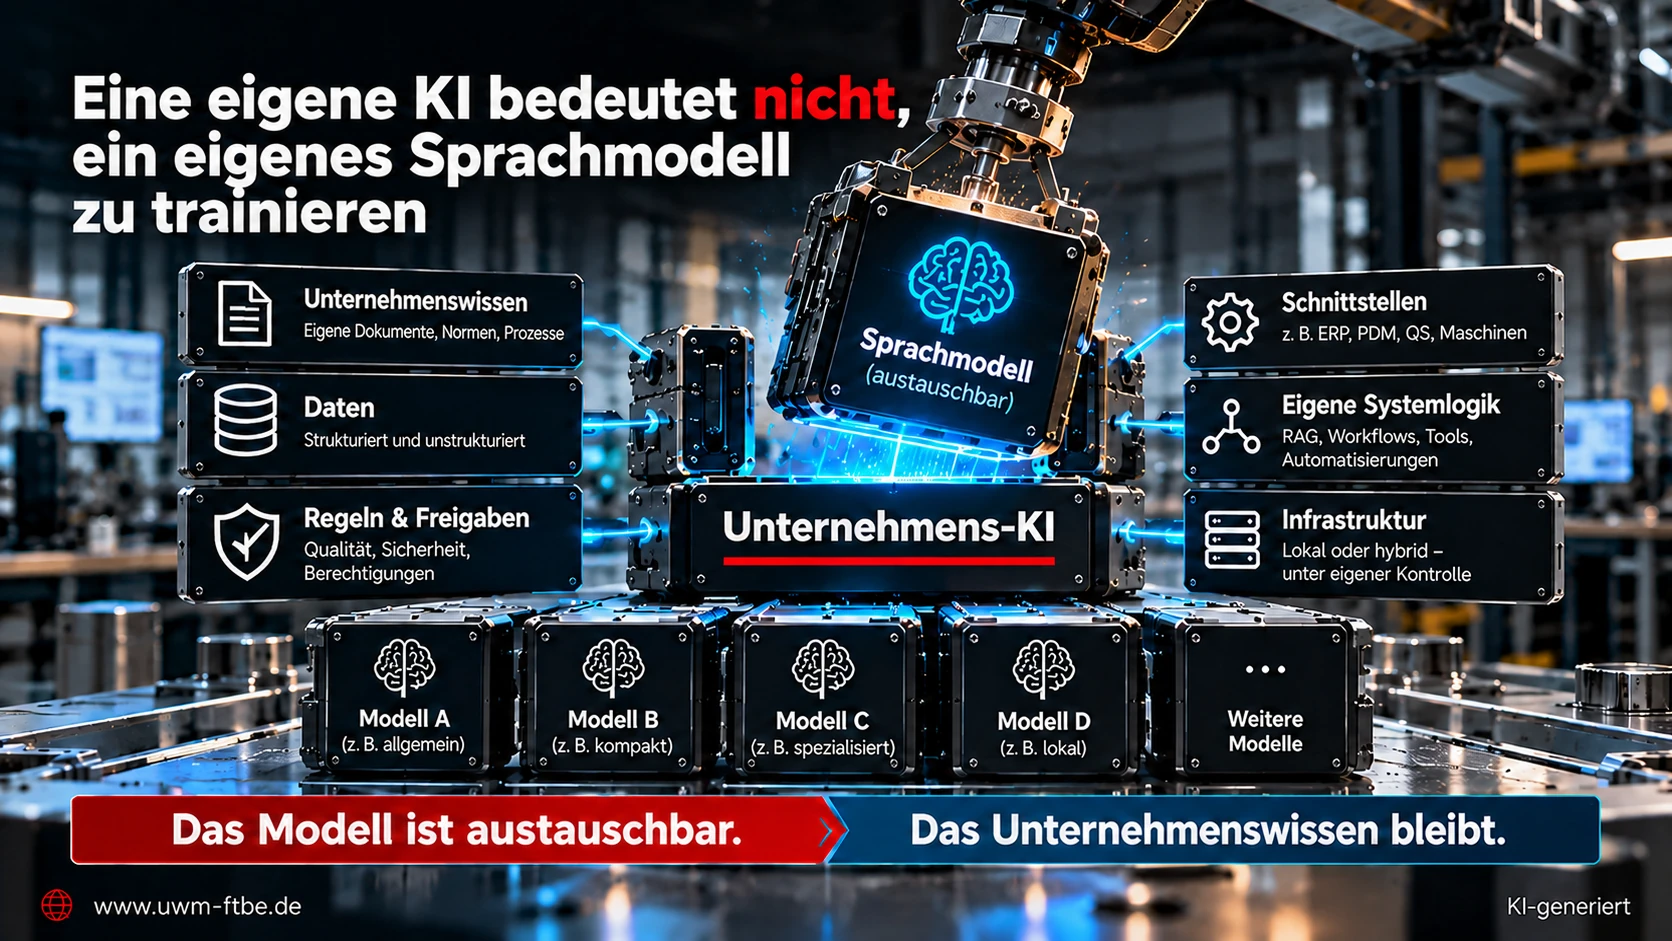
Im Alltag werden KI-Anwendung und Sprachmodell häufig gleichgesetzt. Technisch ist das zu kurz gedacht. Ein Sprachmodell ist eine zentrale Komponente, aber eine Unternehmens-KI kann aus deutlich mehr Bausteinen bestehen: Datenquellen, Dokumentenablage, Such- und Retrieval-Funktionen, Berechtigungen, Freigaben, Schnittstellen, Protokollierung und die eigentliche Benutzeroberfläche.
Ein Unternehmen kann deshalb eine eigene, kontrollierte KI-Anwendung betreiben, ohne die Modellgewichte selbst von Grund auf trainiert zu haben. Vortrainierte Modelle lassen sich lokal oder über externe Dienste verwenden. Welche Variante sinnvoll ist, hängt von Aufgabe, Schutzbedarf, Leistungsbedarf, Lizenzbedingungen und Betriebsaufwand ab.
Was Training von Grund auf eigentlich bedeutet
Ein großes Sprachmodell von Grund auf zu trainieren ist etwas grundlegend anderes als ein vorhandenes Modell einzusetzen. Beim Vortraining startet das Modell ohne die bereits erlernten Gewichte eines fertigen Modells und muss aus sehr großen Datenmengen statistische Sprach- und Wissensmuster lernen.
Für ein typisches kleines oder mittleres technisches Unternehmen ist das normalerweise nicht die erste sinnvolle Aufgabe. Der Aufwand liegt nicht nur in Rechenleistung. Benötigt werden geeignete Daten, Datenaufbereitung, Trainingsinfrastruktur, Tests, Evaluation, Modellpflege und entsprechendes Spezialwissen.
Vortrainierte Modelle verschieben diesen Ausgangspunkt. Sie bringen bereits allgemeine Fähigkeiten mit. Das Unternehmen muss dann nicht noch einmal versuchen, allgemeines Sprachverständnis von Grund auf aufzubauen.
Einfach erklärt: Was bedeutet „ein eigenes Sprachmodell trainieren“?
Ein eigenes Sprachmodell zu trainieren bedeutet, einer KI von Grund auf beizubringen, wie Sprache funktioniert.
Dazu bekommt das System riesige Mengen an Texten und anderen Daten. Während des Trainings lernt es statistische Zusammenhänge: welche Wörter, Begriffe und Satzstrukturen zusammengehören und welche Fortsetzung in einem bestimmten Zusammenhang wahrscheinlich ist.
Vereinfacht kann man es mit einem neuen Mitarbeiter vergleichen:
Ein eigenes Sprachmodell von Grund auf zu trainieren bedeutet ungefähr, jemanden erst Lesen, Schreiben, Sprache und grundlegende Zusammenhänge beizubringen.
Ein vorhandenes Sprachmodell einzusetzen bedeutet dagegen: Wir holen uns jemanden, der bereits lesen, schreiben und allgemeine Zusammenhänge verstehen kann, und bringen ihm anschließend bei, wie bei UWM-FTBE gearbeitet wird und auf welches freigegebene Wissen er zugreifen darf.
Genau deshalb bedeutet „eigene Unternehmens-KI“ nicht automatisch „eigenes Sprachmodell“.
Vereinfacht dargestellt:
Sprachmodell + eigene Dokumente + eigenes Wissenssystem + Regeln + Berechtigungen + Schnittstellen + Qualitätsprüfung = eigene Unternehmens-KI
Das Sprachmodell ist darin ein Bauteil – nicht das gesamte System.
Vier Ebenen, die man sauber voneinander trennen sollte
Für die weitere Serie ist eine klare Begriffstrennung wichtig. Sie verhindert, dass jede Anpassung einer KI vorschnell als „eigenes Modell“ bezeichnet wird.
1. Vortrainiertes Modell verwenden
Die einfachste Ebene ist die Nutzung eines bereits trainierten Modells. Es verarbeitet die gestellte Aufgabe mit seinen vorhandenen Fähigkeiten und dem Kontext, den es für die jeweilige Anfrage erhält. Das Modell selbst wird dabei nicht neu trainiert.
2. Prompt und Systemregeln
Auf der nächsten Ebene wird festgelegt, wie das Modell arbeiten soll: Rolle, Aufgabe, Ausgabeformat, Grenzen und Prüfschritte. Dadurch verändert sich nicht automatisch das Modell selbst. Gute Anweisungen können die Nutzung deutlich strukturieren, ersetzen aber weder Fachwissen noch eine belastbare Datenbasis.
3. Eigenes Wissen gezielt bereitstellen
Unternehmenswissen kann dem Modell zur jeweiligen Aufgabe als zusätzlicher Kontext bereitgestellt werden. Ein verbreitetes Konzept dafür ist Retrieval-Augmented Generation, kurz RAG. Dabei bleibt Wissen in einer externen Wissensbasis und wird bei Bedarf zur Anfrage gesucht und dem Modell als Kontext mitgegeben. Dieses Thema behandeln wir in der weitergeführten KI-Reihe später in Artikel 018 ausführlich.
Für meine Zielarchitektur ist diese Trennung besonders interessant: Dokumente, Herkunft, Revisionen und Freigabestatus können im eigenen Wissenssystem kontrolliert werden, während das Modell als verarbeitende Komponente austauschbar bleibt.
4. Fine-Tuning
Fine-Tuning geht einen Schritt weiter. Dabei wird ein bereits vortrainiertes Modell mit einem kleineren, spezialisierten Datensatz weitertrainiert. Die Modellparameter werden also tatsächlich angepasst. Das ist etwas anderes als RAG oder die bloße Bereitstellung von Dokumenten im Kontext.
Auch Fine-Tuning ist jedoch kein Training eines großen Grundmodells von null. Die Dokumentation von Hugging Face beschreibt Fine-Tuning ausdrücklich als Weitertraining eines vortrainierten Modells und weist darauf hin, dass dafür wesentlich weniger Daten, Rechenleistung und Zeit benötigt werden als beim Training von Grund auf.
Das wertvollste Gut sollte nicht im Modell eingeschlossen sein
Für Unternehmen entsteht ein strategisches Problem, wenn dauerhaftes Wissen untrennbar mit einem bestimmten Modell oder Anbieter verbunden wird. Modelle entwickeln sich schnell weiter. Heute kann Modell A für eine Aufgabe sinnvoll sein, später Modell B oder ein völlig anderer technischer Ansatz.
Deshalb verfolge ich für UWM-FTBE den Grundsatz, Modelle als Werkzeuge zu betrachten. Originaldokumente, Historie, Freigaben und belastbare Ergebnisse sollen in einem kontrollierten Wissenssystem geführt werden. Für die dauerhafte Wissensübernahme gilt dabei die Logik RAW → PROCESSED → APPROVED: Rohmaterial ist nicht automatisch freigegebenes Unternehmenswissen.
Das schafft keine vollständige Herstellerunabhängigkeit – jede konkrete Software besitzt Abhängigkeiten. Es reduziert aber das Risiko, dass ein Modellwechsel gleichzeitig den Verlust oder kompletten Neuaufbau des eigenen Wissenssystems erzwingt.
AUS DER PRAXIS: WARUM WIR MODELL UND UNTERNEHMENSWISSEN TRENNEN
Ausgangslage: Im UWM-FTBE-Projekt „UWM Private AI“ soll KI nicht nur allgemeine Texte erzeugen, sondern perspektivisch mit eigenem technischem Wissen und kontrollierten Unternehmensinformationen arbeiten.
Konkrete Aufgabe: Dafür musste früh geklärt werden, was dauerhaftes Unternehmenswissen ist und was lediglich die jeweils eingesetzte Modellkomponente darstellt.
Vorgehen: Die Zielarchitektur trennt Dokumente, Herkunft, Revisionen, Freigaben, Berechtigungen und Wissensstatus vom Sprachmodell. Das Modell soll diese Informationen für eine Aufgabe nutzen können, ohne selbst zum einzigen dauerhaften Wissensspeicher zu werden.
Entscheidung: Modelle werden als austauschbare Werkzeuge betrachtet. Die dauerhafte Wissens- und Governance-Struktur soll unabhängig davon kontrolliert geführt werden.
Ergebnisstand: Für diesen Artikel ist diese Trennung als dokumentierte Architektur- und Governance-Entscheidung relevant. Ein produktiver Pilot oder messbare Zeit- bzw. Kosteneffekte werden hier ausdrücklich nicht behauptet.
Erkenntnis: Die Frage „Welches Modell?“ ist nur ein Teil der Gesamtaufgabe. Mindestens ebenso wichtig ist, wo Wissen liegt, wie es freigegeben wird und wie ein späterer Modellwechsel möglich bleibt.
Übertragbarkeit: Die konkrete UWM-FTBE-Architektur ist kein allgemeingültiges Rezept. Übertragbar ist die Prüffrage, ob dauerhaftes Unternehmenswissen unnötig an ein einzelnes Modell oder einen einzelnen Anbieter gekoppelt wird.
BEISPIEL: TECHNISCHE DOKUMENTATION
Angenommen, ein Unternehmen besitzt Zeichnungen, Prüfberichte, Arbeitsanweisungen, Lieferantendokumente und ältere Projektunterlagen. Die entscheidende Aufgabe ist nicht, diese Dateien in ein selbst trainiertes Sprachmodell „hineinzutrainieren“.
Sinnvoller ist zunächst die Frage, welche Dokumente gültig sind, welche Revision aktuell ist, woher eine Information stammt und ob sie für die Nutzung freigegeben wurde. Erst wenn diese Wissensbasis belastbar ist, kann ein geeignetes Modell sie bei Suche, Vergleich, Strukturierung oder Dokumentation unterstützen.
Ein leistungsfähigeres Modell kann schlechte Datenorganisation nicht reparieren. Es kann sie höchstens überzeugender überdecken.
Wann wäre Fine-Tuning trotzdem interessant?
Fine-Tuning ist damit keineswegs überflüssig. Es kann sinnvoll werden, wenn ein Modell für eine klar definierte Aufgabe ein bestimmtes Verhalten, eine Fachsprache oder ein reproduzierbares Ausgabeformat besser beherrschen soll und genügend geeignete Trainings- und Testdaten vorhanden sind.
Für Unternehmenswissen, das sich regelmäßig ändert oder dessen Quelle und Aktualität nachvollziehbar bleiben müssen, ist dagegen häufig eine externe Wissensbasis attraktiver. RAG und Fine-Tuning sind keine Gegensätze; sie lösen unterschiedliche Probleme und können miteinander kombiniert werden.
Die Reihenfolge ist entscheidend: Erst die Aufgabe und das Qualitätsziel bestimmen, dann entscheiden, ob Prompting, Wissensbereitstellung, Fine-Tuning oder eine Kombination erforderlich ist.
Was eine eigene Unternehmens-KI für mich deshalb bedeutet
Unter „eigener KI“ verstehe ich im UWM-FTBE-Projekt keine Behauptung, ein eigenes Foundation Model entwickelt zu haben. Gemeint ist eine kontrollierte Unternehmensarchitektur, in der Datenwege, Wissensbestände, Freigaben und eingesetzte Modelle bewusst geführt werden.
Das Modell übernimmt darin eine wichtige Rolle, bleibt aber austauschbar. Die fachliche Verantwortung bleibt ebenfalls beim Menschen. Ein sprachlich überzeugendes Ergebnis ist nicht automatisch technisch richtig – besonders nicht bei Berechnungen, Normen, rechtlichen Aussagen, produktivem Code oder sicherheitsrelevanten Entscheidungen.
Der Leitgedanke bleibt deshalb: KI ist nur so gut wie die fachliche Führung durch den Anwender. Prompt-Kompetenz allein ersetzt keine Fachkompetenz.
Fazit: Die eigene KI beginnt bei der Architektur, nicht beim Modelltraining
Für viele Unternehmen ist die entscheidende Frage nicht, wie sie ein großes Sprachmodell selbst trainieren können. Wichtiger ist, wie sie vorhandene Modelle kontrolliert in eine eigene Arbeits- und Wissensarchitektur integrieren.
Wer Daten, Wissen, Freigaben und Schnittstellen sauber vom Modell trennt, schafft eine wesentlich bessere Grundlage für spätere Veränderungen. Neue Modelle können geprüft und gegebenenfalls ausgetauscht werden, ohne dass das Unternehmen sein gesamtes Wissen neu organisieren muss.
Im nächsten Artikel wird die Frage praktischer: Kann ein normaler Arbeitsplatzrechner überhaupt eine ernsthafte lokale KI betreiben – oder ist dafür sofort spezielle und teure Hardware erforderlich?
Vorheriger Beitrag:
Artikel 007 – Muss eine Unternehmens-KI wirklich in die Cloud?
Nächster Beitrag:
Artikel 009 – Kann mein normaler Rechner eine ernsthafte lokale KI betreiben?
KI im Unternehmen strukturiert aufbauen
UWM-FTBE verbindet technische Fachprozesse, Datenstrukturen und KI-Anwendungen zu einer nachvollziehbaren Gesamtarchitektur. Entscheidend ist nicht das größte Modell, sondern eine Lösung, die zu Aufgabe, Daten, Schutzbedarf und vorhandener Infrastruktur passt.
Quellen – Stand Oktober 2026
Geprüft am 10.10.2026; technische Dokumentationen können sich ändern.
- Hugging Face – Transformers Documentation: Quickstart – Nutzung vortrainierter Modelle.
- Hugging Face – Transformers Documentation: Fine-tuning – Abgrenzung von Fine-Tuning und Vortraining.
- Stanford CRFM – On the Opportunities and Risks of Foundation Models – Originalpublikation, 2021.
Hinweis: Die Quellen dienen der fachlichen Prüfung des Beitrags. Rechtliche und regulatorische Anforderungen sind für den jeweiligen Anwendungsfall aktuell zu prüfen.