
Inhalt
Persönliche Einordnung: Nicht jede Information gehört in dieselbe KI
Im ersten Beitrag dieser Serie ging es um die Frage, warum ich überhaupt über eine eigene KI-Umgebung nachgedacht habe. Sehr schnell wurde für mich deutlich: Die entscheidende Frage ist nicht nur, welches KI-Modell besonders leistungsfähig ist. Viel wichtiger ist zunächst, welche Informationen ich einem System überhaupt anvertrauen möchte.
Im technischen Unternehmensalltag arbeitet man nicht nur mit frei verfügbaren Informationen. Auf dem Bildschirm liegen technische Zeichnungen, Kalkulationen, Angebote, E-Mails, Kundendokumente, interne Notizen, Fotos, Prüfunterlagen, Verträge und manchmal Zugangsdaten nebeneinander. Für einen Menschen ist meist sofort klar, dass diese Informationen nicht alle gleich behandelt werden dürfen. Bei KI muss diese Unterscheidung genauso bewusst erfolgen.
Deshalb habe ich für mich einen einfachen Grundsatz formuliert: Nicht die KI entscheidet, welche Daten sie bekommen darf. Diese Entscheidung muss beim Menschen und bei den dafür verantwortlichen Rollen im Unternehmen bleiben.
Die falsche Frage lautet: Cloud oder lokal?
Wer über Datenschutz und KI spricht, landet schnell bei einer scheinbar einfachen Gegenüberstellung: Cloud ist unsicher, lokal ist sicher. So einfach ist es nicht. Ein professionell betriebener Cloud-Dienst kann umfangreiche Sicherheits- und Datenschutzfunktionen besitzen. Gleichzeitig kann auch ein lokal installiertes System schlecht abgesichert, falsch konfiguriert oder für zu viele Personen zugänglich sein.
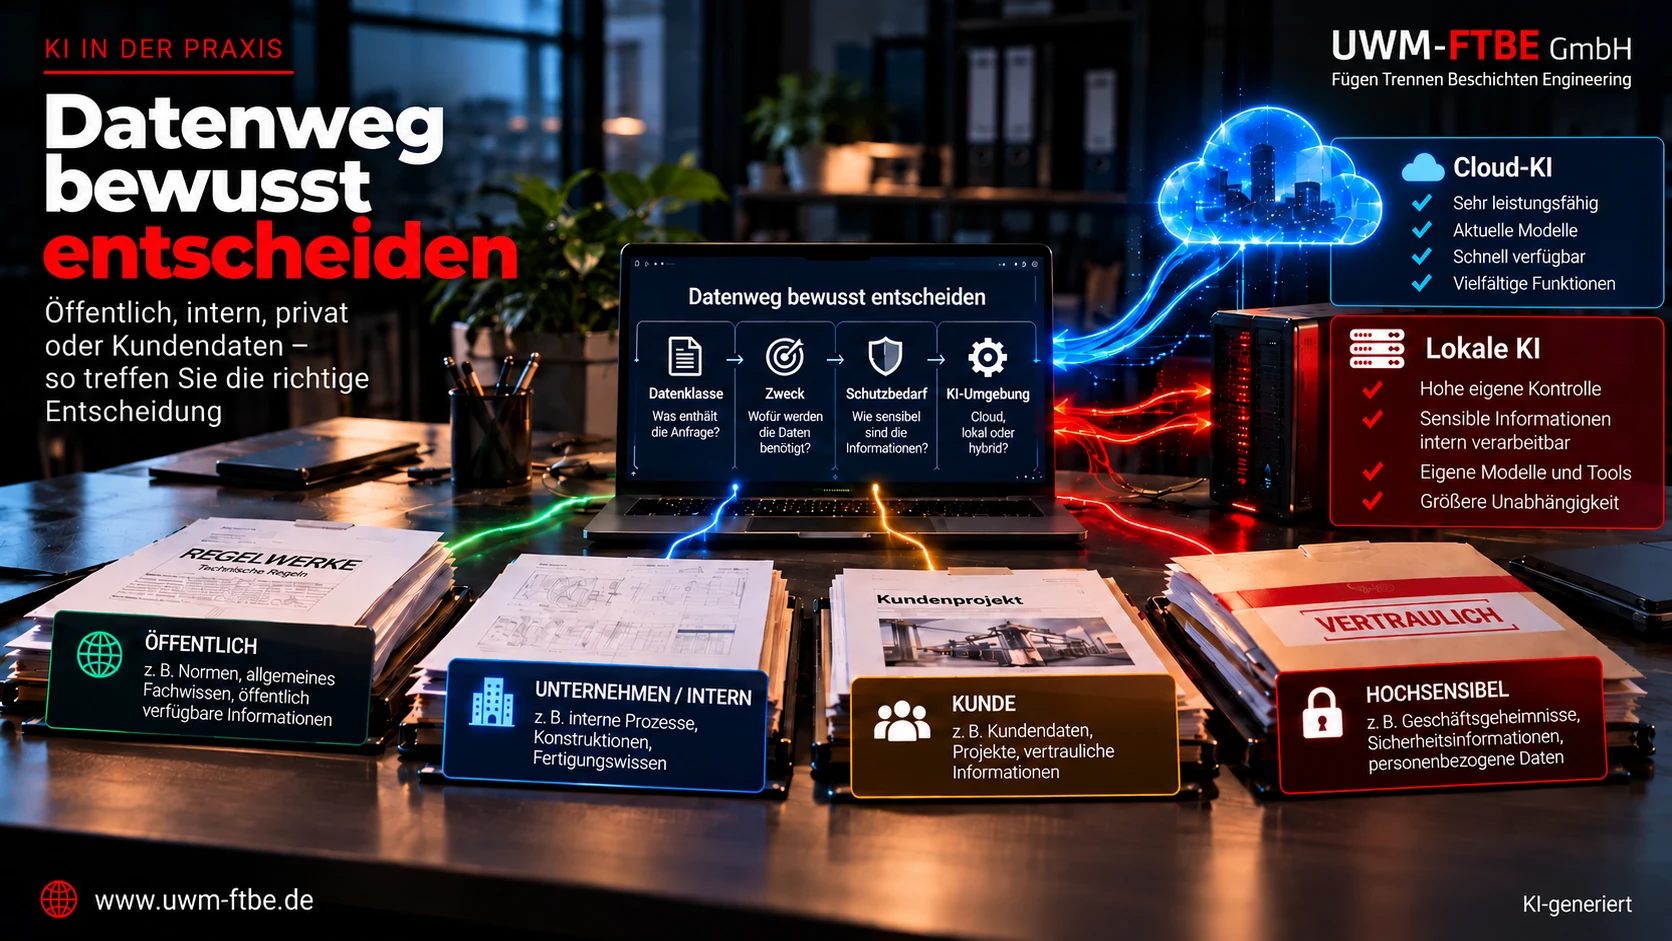
Für mich ist deshalb nicht der Standort des Modells die erste Entscheidungsfrage. Zuerst muss ich wissen, welche Information ich vor mir habe, wofür sie benötigt wird und welche Folgen eine ungewollte Offenlegung, Veränderung oder falsche Weiterverarbeitung hätte. Erst danach kann ich entscheiden, ob eine lokale KI, ein vertraglich geregelter Unternehmensdienst oder überhaupt keine KI der richtige Verarbeitungsweg ist.
Vier Datenklassen als praktische Ausgangsbasis
Für die tägliche Arbeit hilft mir eine einfache Einteilung in vier Gruppen: öffentlich, intern, privat und kundenbezogen. Sie ersetzt keine Datenschutz- oder Informationssicherheitsklassifizierung eines Unternehmens. Sie zwingt mich aber dazu, vor dem Hochladen kurz nachzudenken.
Öffentliche Informationen sind beispielsweise bereits veröffentlichte Webseiteninhalte, eigene veröffentlichte Blogartikel, frei zugängliche Produktinformationen oder öffentlich verfügbare Normenhinweise, soweit deren Nutzung urheberrechtlich zulässig ist. Bei solchen Informationen ist das Vertraulichkeitsrisiko meist geringer. Trotzdem bleiben Urheberrecht, Nutzungsbedingungen und die Frage wichtig, ob eine Verarbeitung überhaupt erforderlich ist.
Interne Informationen sind deutlich schwieriger. Dazu gehören beispielsweise nicht veröffentlichte Kalkulationen, interne Arbeitsanweisungen, Projektplanungen, Prozessbeschreibungen, Fehleranalysen oder strategische Überlegungen. Hier reicht die Aussage „Das ist nur ein Text“ nicht aus. Der Inhalt kann wirtschaftlich wertvoll sein.
Private Informationen betreffen natürliche Personen und den persönlichen Bereich. Dazu können personenbezogene Daten, private Kommunikation, Personalinformationen oder andere sensible Angaben gehören. Sobald personenbezogene Daten verarbeitet werden, kommen zusätzlich die Anforderungen des Datenschutzrechts ins Spiel.
Kundenbezogene Informationen behandle ich besonders vorsichtig. Technische Zeichnungen, Stücklisten, Angebote, Projektdokumente, Fotos, Prüfberichte oder E-Mails können nicht nur personenbezogene Daten enthalten, sondern auch Geschäftsgeheimnisse und vertraglich geschützte Informationen des Kunden. Dass ich technisch Zugriff auf eine Datei habe, bedeutet noch lange nicht, dass ich sie an einen externen KI-Dienst übertragen darf.
Was ich einer normalen Cloud-KI ohne weitere Prüfung nicht geben würde
Bei einer frei oder persönlich genutzten Cloud-KI würde ich schutzbedürftige Unternehmens- und Kundendaten nicht einfach per Copy-and-paste einstellen. Dazu zählen für mich insbesondere vollständige Kundendokumentationen, nicht veröffentlichte technische Zeichnungen, vertrauliche Kalkulationen, Vertragsunterlagen, personenbezogene Datensammlungen, interne Sicherheitsinformationen und Geschäftsgeheimnisse.
Eine noch klarere Grenze bilden Passwörter, API-Schlüssel, private Schlüssel, Wiederherstellungscodes und vergleichbare Zugangsdaten. Solche Geheimnisse gehören nicht in einen normalen KI-Dialog. Auch bei einer leistungsfähigen Unternehmenslösung sollte geprüft werden, ob die KI diese Information für die Aufgabe überhaupt benötigt. In den meisten Fällen lautet die Antwort: nein.
Der wichtigste Gedanke dahinter ist Datenminimierung: Eine KI sollte nicht vorsorglich alles bekommen, nur weil es technisch bequem ist. Sie sollte die Informationen erhalten, die für die konkrete Aufgabe erforderlich und für diesen Verarbeitungsweg freigegeben sind.
Aber: Cloud-KI ist nicht gleich Cloud-KI
Eine wichtige Erkenntnis ist, dass sich die Bedingungen verschiedener KI-Angebote erheblich unterscheiden können. Selbst beim gleichen Anbieter können persönliche Konten, Unternehmens-Workspaces und API-Angebote unterschiedliche Regeln für Training, Aufbewahrung, Administration und Datenkontrolle haben.
OpenAI erklärt beispielsweise aktuell, dass Inhalte aus ChatGPT Business, Enterprise, Edu und der API standardmäßig nicht zum Training der Modelle verwendet werden. Für persönliche ChatGPT-Workspaces gibt es dagegen eigene Datenkontrollen, mit denen die Nutzung neuer Gespräche zur Modellverbesserung deaktiviert werden kann. Microsoft beschreibt für Microsoft 365 Copilot ebenfalls, dass Prompts, Antworten und über Microsoft Graph abgerufene Daten nicht zum Training der zugrunde liegenden Foundation-Modelle verwendet werden.
Genau deshalb wäre die Aussage „Cloud-Daten werden immer zum Training verwendet“ genauso falsch wie „In der Cloud sind meine Daten automatisch sicher“. Entscheidend sind der konkrete Dienst, der Vertrag, die Einstellungen, Aufbewahrungsregeln, Administratorrechte, angeschlossene Apps und die jeweilige Nutzungssituation.
Ein Ampelmodell ist hilfreicher als ein pauschales Verbot
Für die Praxis bevorzuge ich eine Entscheidung in drei Stufen. Grün bedeutet: Die Information ist für diesen Zweck freigegeben und der gewählte KI-Dienst ist dafür geeignet. Gelb bedeutet: Erst prüfen, reduzieren, anonymisieren, pseudonymisieren oder eine andere Umgebung wählen. Rot bedeutet: Nicht an diesen Dienst übermitteln.
Ein veröffentlichter eigener Fachtext kann beispielsweise grün sein. Eine interne Prozessbeschreibung kann gelb sein, wenn nur ein kleiner, nicht vertraulicher Ausschnitt für eine sprachliche Überarbeitung benötigt wird. Eine Kundenzeichnung mit vertraulichen Konstruktionsdetails kann für einen allgemeinen Cloud-Chat rot sein, während sie in einer ausdrücklich freigegebenen, vertraglich und technisch geeigneten Unternehmensumgebung anders bewertet werden könnte.
Wichtig ist: Die Farbe gehört nicht dauerhaft zur Dateiendung. Dieselbe PDF kann je nach Inhalt, Vertrag, Zweck und System unterschiedlich zu bewerten sein. Deshalb braucht es eine nachvollziehbare Regel und nicht nur ein Bauchgefühl.
Daten reduzieren, bevor die KI sie sieht
Viele Aufgaben lassen sich lösen, ohne das vollständige Originaldokument an eine KI zu geben. Für eine Formulierung kann ein neutralisierter Textausschnitt reichen. Für die Erklärung eines technischen Problems können Bauteilbezeichnungen, Kundennamen, Auftragsnummern und Preise entfernt werden. Für eine Tabellenlogik können synthetische Beispieldaten genügen.
Diese Reduktion ist nicht nur Datenschutz. Sie verbessert häufig sogar die Arbeitsweise: Weniger irrelevanter Kontext zwingt dazu, die eigentliche Fragestellung sauberer zu formulieren. Auch hier zeigt sich der Grundsatz aus dem ersten Artikel: KI ist nur so gut wie die fachliche Führung durch den Anwender.
Der Mensch muss die Datenroute bestimmen
Je stärker KI-Systeme automatisiert werden, desto wichtiger wird dieser Punkt. Ein Agent, der selbstständig Dateien durchsucht, Dokumente auswählt und externe Dienste aufruft, kann sehr nützlich sein. Er darf aber nicht deshalb automatisch die Befugnis erhalten, sensible Informationen nach außen zu übertragen.
Für mich ist deshalb die Datenroute eine Governance-Entscheidung: Welche Quelle darf gelesen werden? Welche Datenklasse liegt vor? Welche Verarbeitung ist erlaubt? Welcher Dienst darf verwendet werden? Was muss lokal bleiben? Was muss vor der Verarbeitung reduziert werden? Und wer gibt neue Regeln frei?
Automatisierung darf die Entscheidung unterstützen. Die Verantwortung darf sie nicht unsichtbar machen.
Was aktuelle Anbieterregeln zeigen
Die aktuellen Herstellerinformationen bestätigen, warum diese Unterscheidung notwendig ist. OpenAI trennt zwischen persönlichen Datenkontrollen und geschäftlichen Angeboten. Bei geschäftlichen Angeboten werden Eingaben und Ausgaben nach Anbieterangabe standardmäßig nicht für das Modelltraining verwendet. Bei persönlichen Workspaces kann die Modellverbesserung über die Datenkontrollen deaktiviert werden. Die OpenAI-API besitzt wiederum eigene Regeln zu Speicherung und Aufbewahrung.
Google weist für die Gemini Apps ausdrücklich darauf hin, keine vertraulichen Informationen einzugeben, die man nicht von Prüfern einsehen oder zur Verbesserung von Diensten verwendet wissen möchte, wenn entsprechende Aktivitätseinstellungen gelten. Das zeigt: Schon innerhalb der Kategorie „Cloud-KI“ existieren unterschiedliche Datenmodelle und Kontrollmöglichkeiten.
Für ein Unternehmen folgt daraus nicht, einen bestimmten Anbieter pauschal zu wählen oder auszuschließen. Es folgt daraus, die Bedingungen des tatsächlich eingesetzten Produkts zu prüfen und Änderungen regelmäßig nachzuverfolgen.
Datenschutz ist nur ein Teil der Entscheidung
Bei der Datenfrage wird häufig nur an personenbezogene Daten gedacht. Für ein technisches Unternehmen ist das zu kurz gegriffen. Eine Zeichnung kann völlig ohne personenbezogene Daten auskommen und trotzdem hochvertraulich sein. Eine Kalkulation kann ein Geschäftsgeheimnis enthalten. Eine interne Fehleranalyse kann Rückschlüsse auf Fertigungsprozesse ermöglichen. Ein Quellcode kann Zugangspfade oder Sicherheitsmechanismen offenlegen.
Deshalb betrachte ich mindestens vier Ebenen gleichzeitig: Datenschutz, Vertraulichkeit, geistiges Eigentum beziehungsweise Nutzungsrechte und geschäftliche Bedeutung. Erst diese Kombination ergibt eine brauchbare Entscheidung.
Praxischeck vor dem Hochladen
Bevor ich eine nicht öffentliche Information an eine externe KI gebe, möchte ich vier Fragen beantworten können. Sie ersetzen keine projektspezifische Datenschutz-, Rechts- oder Informationssicherheitsprüfung, schaffen aber eine klare Entscheidungsschwelle.
- Wem gehört die Information und welche Rechte oder Pflichten sind damit verbunden?
- Darf ich sie für diesen konkreten Zweck mit genau diesem Dienst verarbeiten?
- Muss die KI wirklich den vollständigen Inhalt sehen, oder reicht ein reduzierter beziehungsweise neutralisierter Ausschnitt?
- Ist genau diese KI-Umgebung für die betreffende Datenklasse freigegeben?
Fazit: Nicht die KI entscheidet über meine Daten
Die entscheidende Erkenntnis ist für mich nicht, dass Cloud-KI grundsätzlich vermieden werden muss. Cloud-Systeme können leistungsfähig, komfortabel und für viele Aufgaben sehr sinnvoll sein. Aber Bequemlichkeit darf nicht die Datenklassifizierung ersetzen.
Öffentliche Informationen, interne Unterlagen, private Daten und Kundendokumente brauchen unterschiedliche Regeln. Und diese Regeln müssen gelten, bevor ein Prompt abgeschickt oder ein Agent automatisiert wird.
Genau daraus ergibt sich der nächste Schritt dieser Serie: Wenn die Datenroute geklärt ist, lohnt sich die wirtschaftliche Frage. Was kann KI in einem technischen Unternehmen tatsächlich verändern – jenseits von E-Mails, Textkorrekturen und kleinen Spielereien?
Hinweis: Dieser Beitrag beschreibt ein praktisches Entscheidungsmodell und ersetzt keine individuelle Datenschutz-, Rechts- oder Informationssicherheitsprüfung.
Hinweis zu rechtlichen und regulatorischen Informationen – Stand September 2026
Dieser Beitrag wurde mit fachlicher Sorgfalt und auf Grundlage der zum Zeitpunkt der Veröffentlichung verfügbaren Informationen erstellt. Trotz sorgfältiger Recherche können Fehler, Unvollständigkeiten oder zwischenzeitliche Änderungen der Rechts- und Informationslage nicht vollständig ausgeschlossen werden.
Rechtliche und regulatorische Anforderungen an den Einsatz künstlicher Intelligenz entwickeln sich weiter. Die entsprechenden Informationen in diesem Fachbeitrag geben daher den zum Veröffentlichungszeitpunkt recherchierten Stand wieder und stellen keine Rechtsberatung dar.
Für konkrete betriebliche Anwendungen sind die jeweils aktuellen gesetzlichen Vorgaben, behördlichen Veröffentlichungen, vertraglichen Verpflichtungen sowie die Bedingungen der eingesetzten Systeme und Dienste zu prüfen.
Datenwege vor dem KI-Einsatz bewusst festlegen
Wenn im Unternehmen unklar ist, welche Informationen in welche KI-Umgebung dürfen, sollte diese Entscheidung nicht jedem einzelnen Prompt überlassen bleiben. UWM-FTBE unterstützt dabei, Datenklassen, Anwendungsfälle, Verantwortlichkeiten und technische Verarbeitungswege so zu strukturieren, dass KI praktisch nutzbar wird, ohne Datenkontrolle und fachliche Verantwortung aus der Hand zu geben.
Quellen / fachliche Grundlage
Der Beitrag basiert auf der praktischen UWM-FTBE-Projektarbeit zur kontrollierten KI-Nutzung. Zeit- und anbieterabhängige Aussagen wurden am 26.09.2026 anhand aktueller Primärquellen geprüft. Vor einer späteren Veröffentlichung nach längerer Liegezeit sollten diese Angaben erneut kontrolliert werden.
- OpenAI: Business data privacy, security, and compliance sowie Data controls in ChatGPT – Angaben zu Geschäftsdaten, Training und Datenkontrollen.
- Microsoft Learn: Data, Privacy, and Security for Microsoft Copilot – Angaben zur Verarbeitung von Prompts, Antworten und Microsoft-Graph-Daten.
- Google: Privacy Hub für Gemini-Apps – Datenschutzhinweise, Aktivitätseinstellungen und Hinweise zu vertraulichen Informationen.
- EUR-Lex: Datenschutz-Grundverordnung, insbesondere Art. 5 – Grundsätze der Verarbeitung personenbezogener Daten.
- BSI: Generative AI Models – Opportunities and Risks – fachliche Einordnung von Risiken generativer KI.
- UWM-FTBE GmbH: eigene Projektarbeit und Praxiserfahrung zur kontrollierten KI-Nutzung.